Gümüşhane Üniversitesi, 2008'de kurulan Karadeniz bölgesinin devlet üniversitesidir. Bilimsel Araştırma Projeleri Koordinatörlüğü, «Dijital Dönüşümün Finansal Performans Üzerindeki Etkisi: BIST Sürdürülebilirlik Endeksi Üzerine Text-Mining Tabanlı Analiz» (BAP No: 26.B0311.02.01) başlıklı araştırmayı yürütmektedir. Çalışma, 2024 yılı sonu itibarıyla BIST Sürdürülebilirlik Endeksi'nde yer alan 25 işletmenin faaliyet raporu, sürdürülebilirlik raporu, entegre rapor, finansal denetim raporu ve KAP açıklamalarını kapsar.
ACADEMIC DATA ANALYTICS · PUBLIC TENDER · STATE UNIVERSITY
Gümüşhane Üniversitesi
Under a research project supported by the Gümüşhane University Scientific Research Projects Office and led by Assoc. Prof. Fahrettin Pala, corporate reports of 25 firms on the BIST Sustainability Index are analysed using text-mining methods. AIOR Teknoloji Limited Şirketi carried out the data collection, processing and delivery processes for this project under a public tender. Within this scope, a ten-year corporate document archive for 2015–2024 was compiled systematically; annual reports, sustainability reports, integrated reports, independent audit reports and Public Disclosure Platform (KAP) disclosures were processed through OCR and natural language processing (NLP). As a result, the university research team received 910 unique PDF documents, a fully verified 1,250-cell source matrix, a 35.8-million-word text corpus, digitalisation scores, a panel dataset comprising 19 variables, and an offline delivery portal that documents the full workflow step by step.
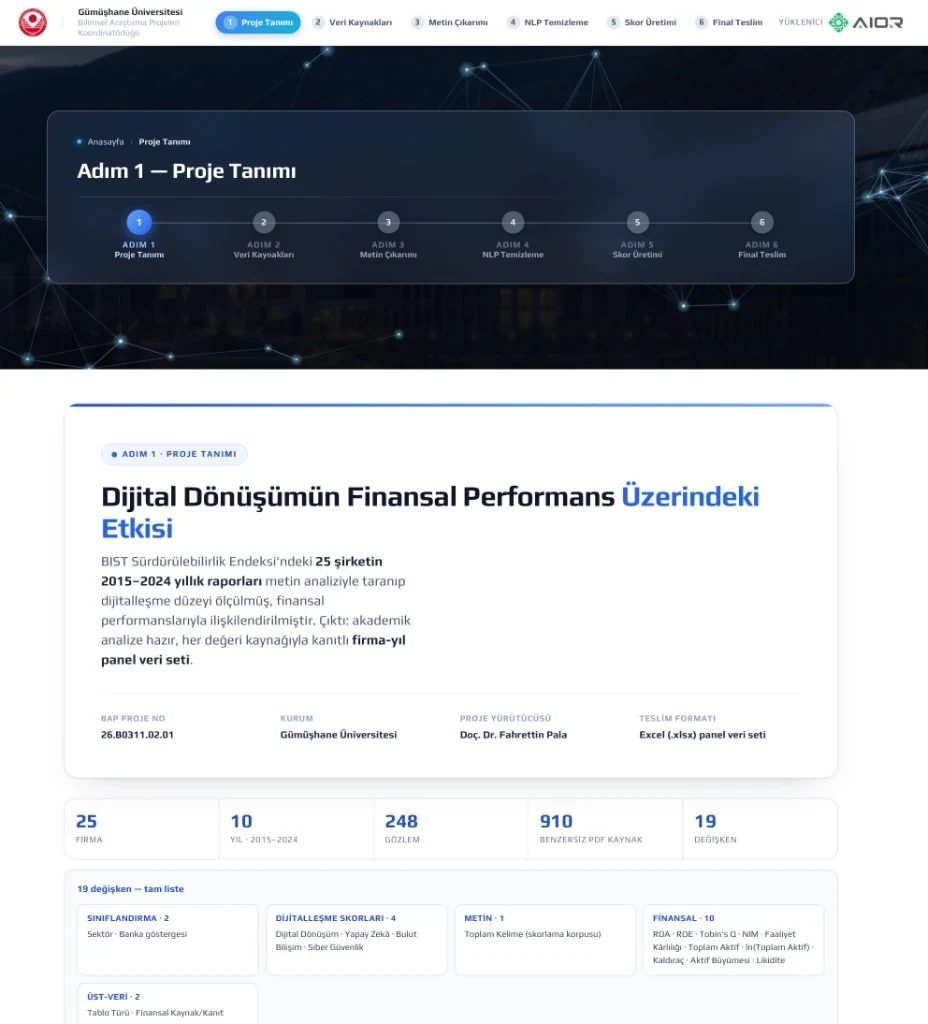
PROJE GÖRSELLERİ
Teslim edilen dijital deneyimden kareler
PROJE HİKAYESİ
Proje özeti ve kapsam
Gümüşhane Üniversitesi Bilimsel Araştırma Projeleri Koordinatörlüğü tarafından desteklenen ve Doç. Dr. Fahrettin Pala yürütücülüğünde yürütülen araştırma kapsamında, BIST Sürdürülebilirlik Endeksi'nde yer alan 25 işletmenin kurumsal raporları metin madenciliği yöntemleriyle analiz edilmektedir. AIOR Teknoloji Limited Şirketi, söz konusu projenin veri toplama, işleme ve teslim süreçlerini kamu ihalesi kapsamında gerçekleştirmiştir. Bu kapsamda, 2015–2024 dönemine ait on yıllık kurumsal belge arşivi sistematik olarak derlenmiş; faaliyet raporları, sürdürülebilirlik raporları, entegre raporlar, bağımsız denetim raporları ve Kamuyu Aydınlatma Platformu (KAP) açıklamaları OCR ve doğal dil işleme (NLP) süreçlerinden geçirilmiştir. Çalışma sonucunda üniversite araştırma ekibine 910 benzersiz PDF doküman, doğrulaması tamamlanmış 1.250 hücrelik kaynak matrisi, 35,8 milyon kelimelik metin korpusu, dijitalleşme skorları, 19 değişkenden oluşan panel veri seti ve tüm iş akışını adım adım gösteren çevrimdışı teslim portalı eksiksiz olarak teslim edilmiştir.
Proje kapsamı, araştırmanın ihtiyaç duyduğu tüm veri altyapısını uçtan uca kurmaktı. AIOR; 25 işletme, 5 belge türü ve 10 yıllık dönem için ham veriyi topladı, yapılandırılmış PDF arşivi oluşturdu, firma-yıl-kategori matrisini hazırladı. Metin çıkarımında PyMuPDF ve Tesseract birlikte kullanıldı; Türkçe ve İngilizce metinler temizlenip tokenize edildi. Dijitalleşme sözlüğü ve TF-IDF skorları üretildi. Panel veri seti Excel formatında, değişken sözlüğü (codebook) ile birlikte teslim edildi. Ayrıca 23 sayfalık offline HTML portalı, metodoloji raporu, istatistiksel özet, rastgele kanıt denetimi ve akademik kullanım lisansı pakete dahil edildi. Tüm dosyalar yaklaşık 5,3 GB'lık Teslim.zip arşivinde birleştirildi.
Akademik bir teslimde en kritik beklenti, her veri noktasının kaynağının net biçimde izlenebilmesidir. 1.250 hücrelik matriste her firma-yıl-kategori kesişimi için benzersiz PDF, SHA256 özeti, yerel dosya yolu ve canlı URL birlikte doğrulanmalıydı. KAP indirme bağlantılarındaki boşluklar, tarama kalitesindeki PDF'lerde OCR gürültüsü, entegre raporların bileşenlerine ayrıştırılması ve finansal tablolardan ROA, ROE, Tobin's Q, NIM gibi değişkenlerin tutarlı çıkarımı uzun süreli mühendislik çalışması gerektirdi. Kamu ihalesi koşullarında teslim tarihi, teknik şartname uyumu ve veri bütünlüğü aynı anda sağlanmak zorundaydı.
AIOR altı aşamalı bir veri boru hattı kurdu. Önce benzersiz kaynak kataloğu oluşturuldu; ardından yapılandırılmış arşiv ve matris eşlemesi tamamlandı. Metin çıkarımında metin katmanı olan PDF'ler doğrudan okundu, tarama kalitesindekiler Tesseract ile OCR'dan geçirildi. spaCy tabanlı NLP hattı Türkçe ve İngilizce metinleri temizledi. Dijitalleşme sözlüğü ile TF-IDF skorları üretildi; panel veri seti hazırlandı. Her hücre için kaynak PDF, ham metin ve NLP çıktısını yan yana gösteren karşılaştırma ekranı eklendi. Teslim boyunca HTML raporlar, CSV kayıtları ve arşiv dosyaları aynı rakamları gösterecek şekilde senkronize tutuldu.
TESLİM EDİLEN İŞLER
Proje kapsamında tamamlanan modüller
- 01Kamu ihalesi sürecine uygun proje yönetimi, teknik şartname takibi ve teslim takvimi
- 02910 benzersiz PDF'in toplanması; her dosya için SHA256 özeti, yerel yol ve canlı kaynak URL eşlemesi
- 031.250 hücrelik firma-yıl-kategori matrisi (faaliyet, sürdürülebilirlik, entegre, finansal, KAP)
- 04PDF metin çıkarımı: 439 metin katmanı + 471 hibrit OCR; toplam ~35,8 milyon kelime
- 05Türkçe ve İngilizce NLP temizleme, tokenizasyon ve skorlama korpusu
- 06Dijitalleşme sözlüğü ile alt skorlar: dijital dönüşüm, yapay zekâ, bulut, siber güvenlik
- 07248 gözlemli, 19 değişkenli panel veri seti ve değişken sözlüğü
- 08Offline teslim portalı, belge karşılaştırma ekranları, metodoloji raporu ve Teslim.zip arşivi
- 09Rastgele kanıt denetimi, istatistiksel özet ve akademik kullanım lisansı
TEKNOLOJİ STACK'İ
Kullanılan platform ve araçlar
PythonspaCyscikit-learnPyMuPDFTesseract OCRPlaywrightpandasopenpyxlTF-IDFSHA256 Evidence ChainOffline HTML PortalPublic Tender DeliveryBAP Academic Dataset
1.250
Kanıtlanmış matris hücresi
910
Benzersiz kaynak (PDF + OCR)
248
Firma-yıl gözlemi
19
Panel değişkeni
AIOR PROJE NOTU
Bu projede her rakamın arkasında bir belge, her belgenin arkasında bir kaynak var. Gümüşhane teslimi, araştırmacının ham PDF'den analiz çıktısına kadar tüm yolu tek pakette görebilmesini sağlayan, denetlenebilir bir veri altyapısı olarak tamamlandı.
Teslim edilen kapsam ve devamlılık
Teslim 8 Haziran 2026'da tamamlandı. Üniversite araştırma ekibi; panel veri seti, değişken sözlüğü, CSV kaynak dosyaları, istatistiksel özet, belge karşılaştırma ekranları ve altı adımlı offline portalı eksiksiz aldı. 910 benzersiz PDF, 910 OCR metin dosyası ve 1.250 matris hücresinin tamamı doğrulandı. Araştırmacılar ham belgeden NLP çıktısına kadar her adımı izleyebilir; veri seti akademik tekrarlanabilirlik için hazır durumda.